En bref. Une capture de la maquette donnée comme référence de structure suffit pour que l’image générée respecte les baies, l’escalier, la véranda et le volume. Sur seize images et quatre modèles d’image, aucune n’a déformé le bâtiment. La différence entre modèles se joue sur ce qui n’est pas modélisé : FLUX 3 et Seedream 5 Pro gardent les meubles en blocs de la maquette, GPT Image 2.5 et Nano Banana 2.1 les remplacent par du vrai mobilier. En vidéo, les deux modèles testés ont produit le même défaut, un fondu au milieu du plan, et la cause n’était pas le modèle vidéo mais nos deux images clés, rendues séparément, avec deux décors différents. Corrigé en rendant l’image de fin avec l’image de début comme référence de style. Coût : 8 crédits par image, 48 crédits pour 8 secondes avec H3 Max, 288 avec Seedance 2.5.
Pourquoi ce test
Un architecte a souvent une maquette 3D grossière bien avant d’avoir un rendu. Pour une réunion de quartier, un dossier de candidature ou un client qui ne lit pas les plans, il voudrait une image d’ambiance en une heure, pas en une semaine. La question n’est pas « est-ce que l’IA fait de belles images », elle en fait. La question est : est-ce que l’image respecte la maquette, et qu’est-ce qu’elle ajoute sans le dire.
Nous avons pris une maquette que nous connaissons bien, celle de la maison de la Cour des Mineurs à Liège, déjà publiée sur ce site avec sa méthode de reconstitution, et son aménagement imaginé en « maison du parc ». Le test a eu lieu les 29 et 30 octobre 2026, dans le studio de rendu de notre modeleur 3D, qui donne accès à ces modèles d’image et de vidéo. Le même soir, les deux captures de départ ont été soumises à quatre modèles d’image sur une plateforme tierce, avec un prompt identique, pour voir si le résultat tient au modèle ou à la méthode.
Test 1 : deux vues extérieures
Nano Banana 2.1, avec la capture de la maquette en référence « structure » et le prompt d’une photo d’architecture par temps couvert. Une image par vue, 8 crédits chacune, aucune reprise.
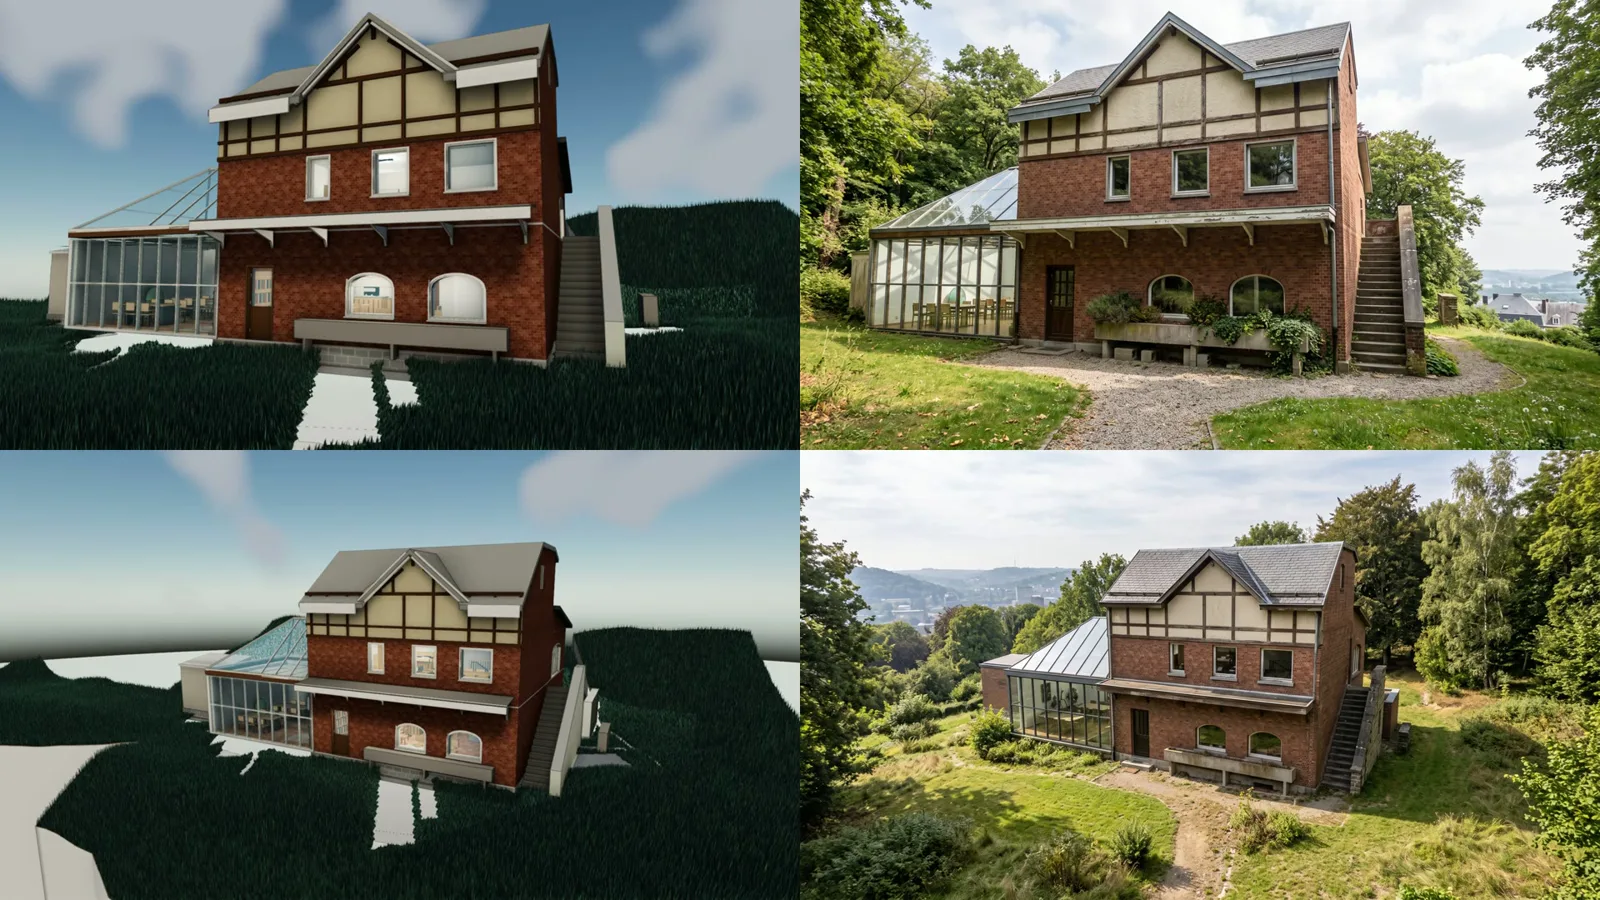
Ce qui tient : le gabarit, le nombre et la position des fenêtres, la pente du toit, la véranda et sa structure, l’escalier extérieur, le pan de colombages. Ce qui change : tout ce qui n’est pas modélisé. La maquette n’a pas de chemin, l’image en a un. La maquette n’a pas de vue, l’image montre la vallée. Rien de cela n’est faux pour une image d’ambiance, mais rien de cela n’est dans le modèle, et un lecteur qui prend l’image pour un relevé se trompe.
Test 2 : six vues intérieures
Même recette, à l’intérieur de l’aménagement imaginé : café, salle polyvalente dans la véranda, atelier, classe, chambre, logement sous les combles. Une capture par pièce depuis une caméra à hauteur d’yeux, le rendu du café en référence de style pour les cinq autres afin d’unifier la lumière et les matières. Six images générées, six retenues, 48 crédits.
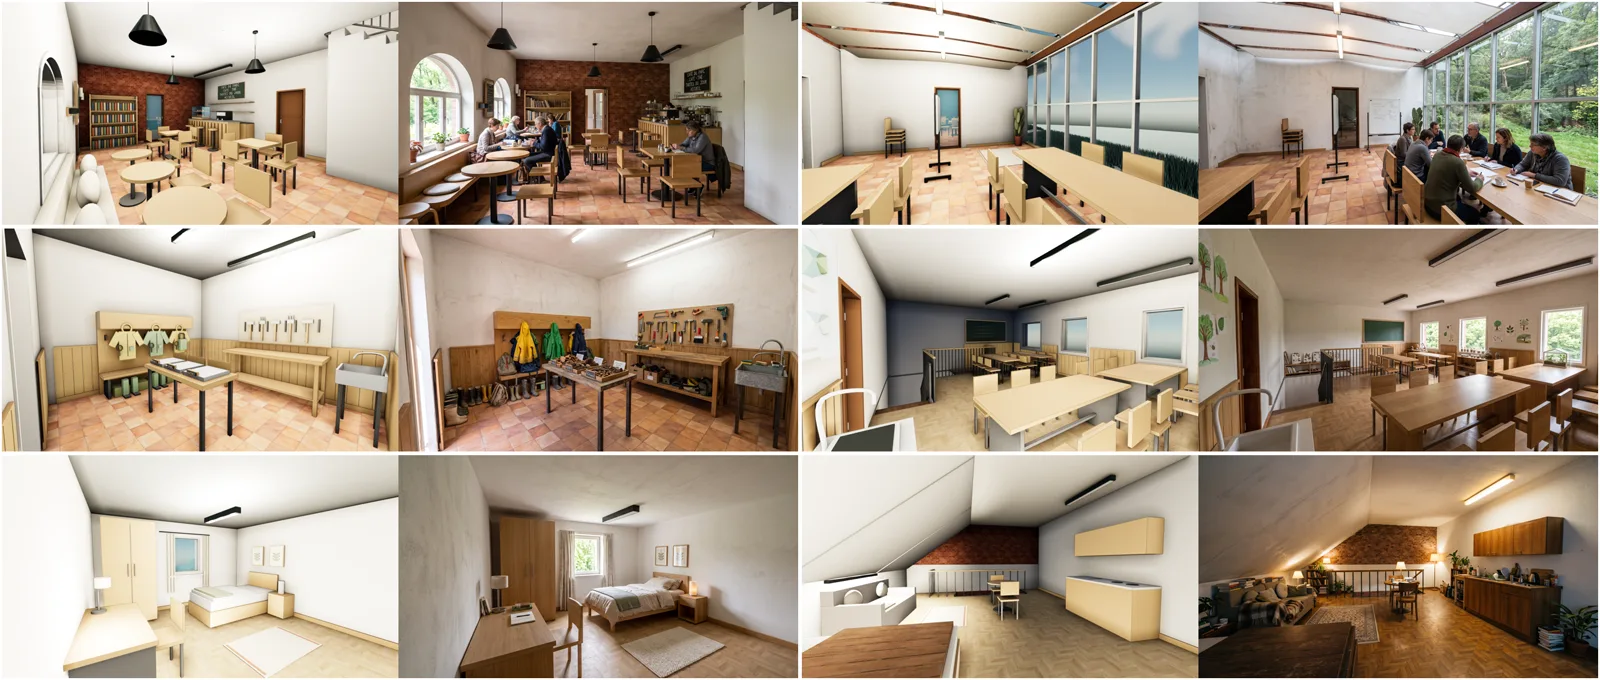
Deux remarques d’honnêteté. La classe telle que meublée dans la maquette compte une vingtaine de places alors que le programme en prévoit douze : l’image reproduit fidèlement une erreur de la maquette, elle ne la corrige pas. Et la salle polyvalente est rendue sous une verrière plus haute et plus lumineuse que celle du modèle : quand la capture est ambiguë, l’IA choisit la version la plus flatteuse.
Test 3 : une vidéo de 8 secondes entre deux images
C’est là que ça s’est compliqué. Nous voulions un plan qui recule devant la façade et découvre le parc, entre deux images clés : la vue de face et la vue depuis la pente, celles du test 1. Trois chemins ont été essayés.
Chemin A, la caméra du modeleur avec un rendu « fidèle ». Le studio propose de filmer un parcours de caméra dans la maquette et de le passer par H3 Max en demandant de garder le style de la 3D. Résultat propre, 48 crédits par plan de 8 secondes, 252 crédits pour cinq plans. Mais fidèle veut dire fidèle : la vidéo ressemble à la maquette, pas à une photo. Bon pour présenter le modèle, pas pour une image d’ambiance.
Chemin B, image de début et image de fin. Les deux rendus du test 1 donnés comme première et dernière image, avec H3 Max puis avec Seedance 2.5. Les deux modèles ont produit le même défaut : au milieu du plan, un fondu enchaîné entre deux scènes qui ne se ressemblent pas. Normal. Les deux images avaient été générées séparément, chacune avec son chemin, ses arbres, sa lumière. Le modèle vidéo ne pouvait pas inventer un mouvement de caméra qui relie deux décors différents, il a fait un fondu.
Chemin C, les mêmes images, rendues ensemble. L’image de fin a été refaite avec deux références : la capture de la maquette en structure, et le rendu de début en style, avec la consigne de reproduire exactement la même scène. Puis Seedance 2.5 entre ces deux images. Cette fois, un vrai recul de caméra, continu, sans rupture. 288 crédits pour 8 secondes.
Test 4 : les mêmes captures, quatre modèles d’image
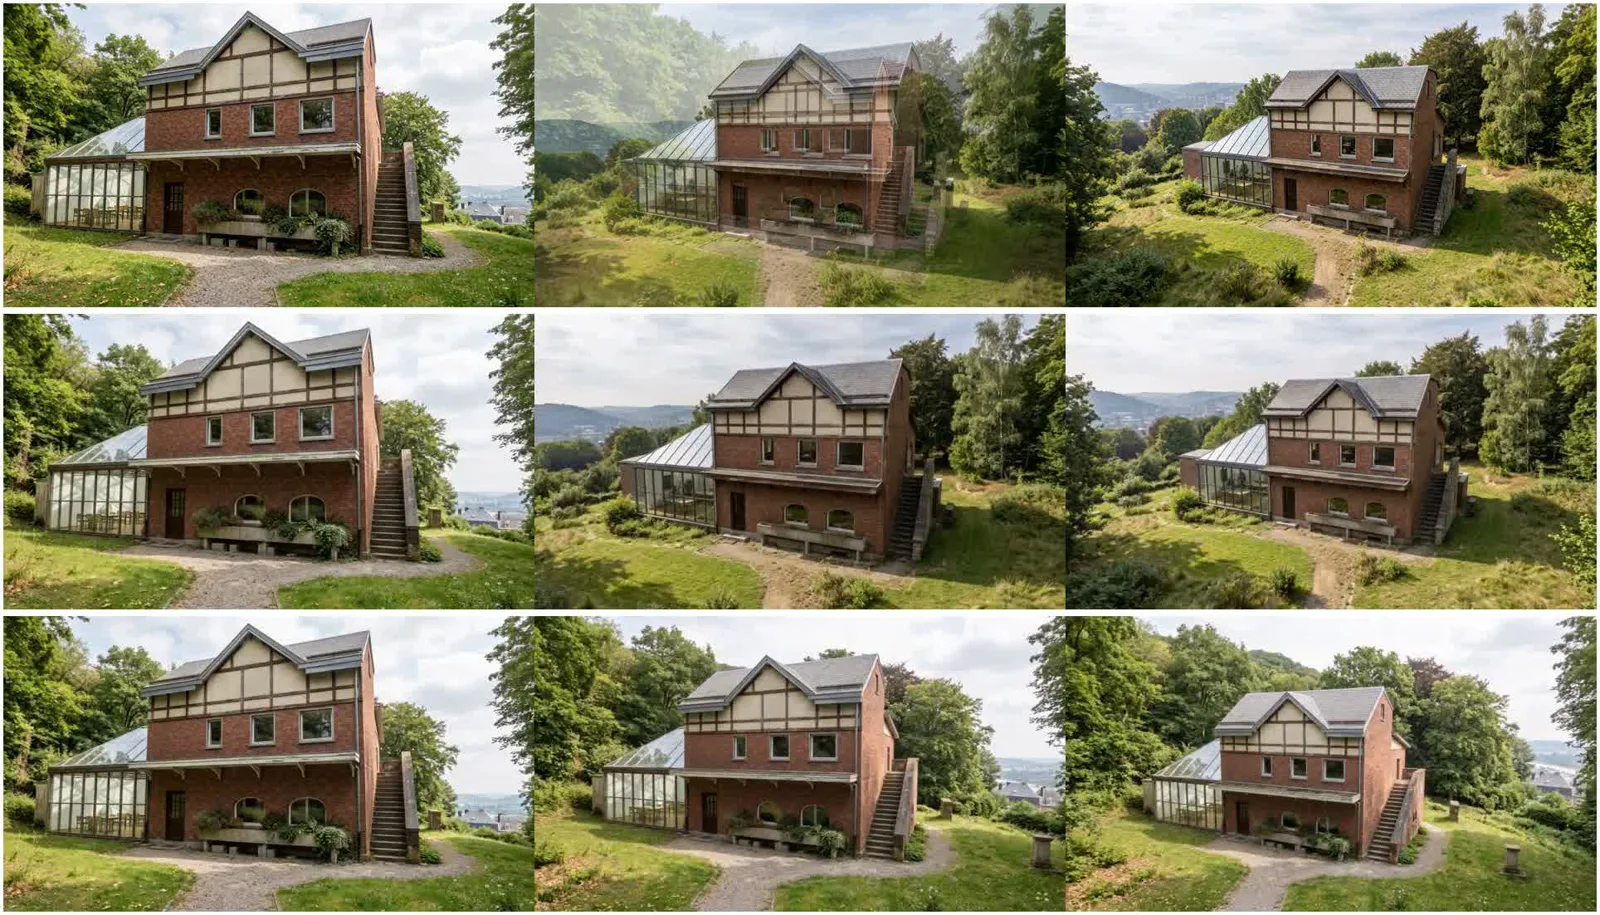
Pour isoler l’effet du modèle, la capture extérieure et la capture du café ont été envoyées telles quelles, avec le même prompt en anglais (« photographie réaliste de exactement ce bâtiment, depuis exactement ce point de vue, ne rien ajouter, retirer ni déplacer »), à quatre modèles via la plateforme FLORA : GPT Image 2.5, le modèle d’images d’OpenAI qu’on retrouve dans ChatGPT ; FLUX 3 Image de Black Forest Labs ; Seedream 5 Pro de ByteDance ; et Nano Banana 2.1 de Google, le même que dans le studio, comme point de comparaison. Une génération par couple, sans reprise, le 30 octobre 2026.
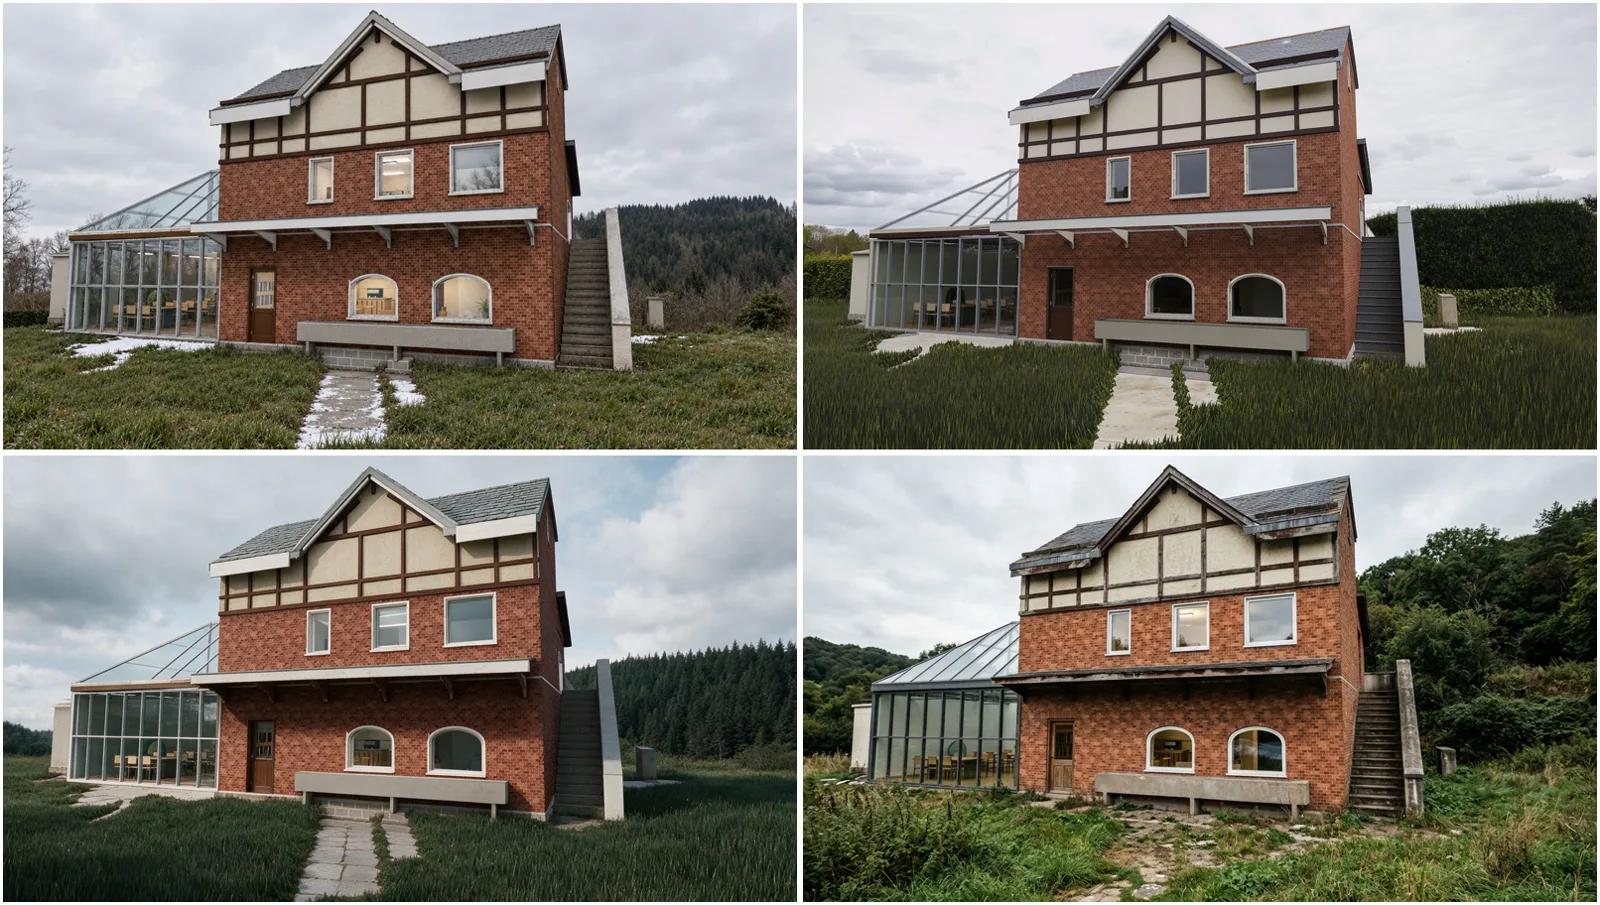
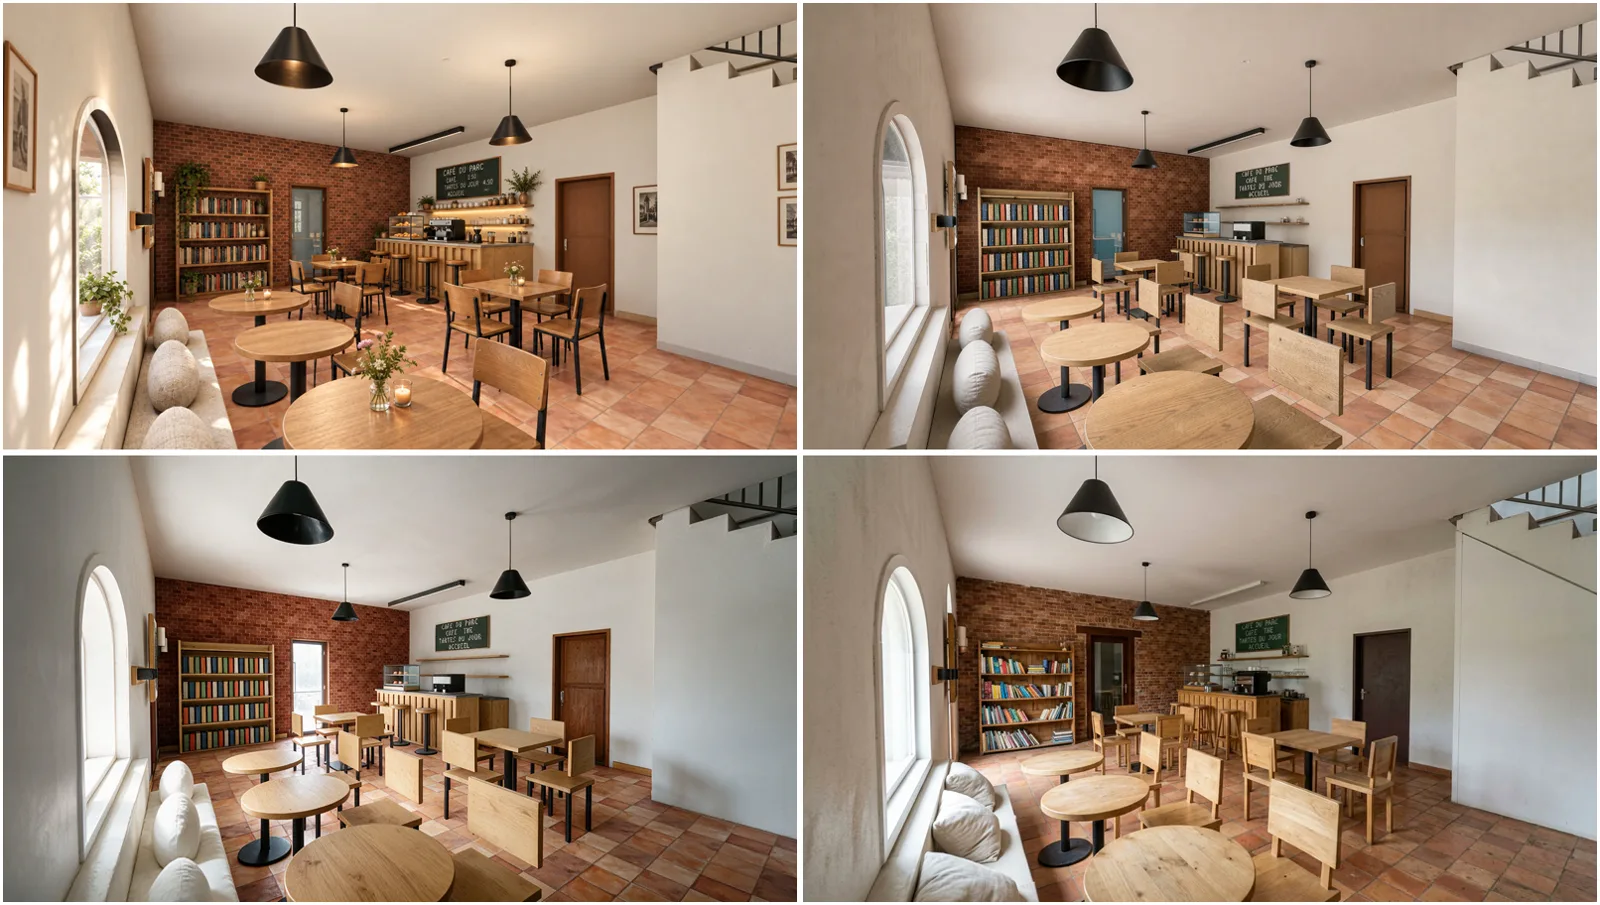
Ce que ça montre. En extérieur, le modèle ne change presque rien à la fidélité : la capture suffit, les quatre tiennent le volume. En intérieur, deux comportements apparaissent. FLUX 3 et Seedream 5 Pro traitent la capture comme une image à habiller : lumière et matières deviennent réalistes, mais les meubles restent ceux de la maquette, en blocs, et l’image garde un air de 3D. GPT Image 2.5 et Nano Banana 2.1 traitent la capture comme une scène à réinterpréter : ils remplacent le mobilier par des objets plausibles, ajoutent des coussins, des plantes, des cadres, un menu au tableau. Plus photographique, moins fidèle. Aucun des deux comportements n’est le bon dans l’absolu : pour vérifier une implantation de meubles, les deux premiers ; pour une image d’ambiance, les deux autres.
Côté prix, sur cette plateforme, les quatre images extérieures ont coûté entre 5 et 9 cents chacune (FLUX 3 le moins cher, Seedream 5 Pro le plus cher), soit 0,51 $ pour les huit images du test.
Ce que ça coûte
Les crédits sont ceux du studio de rendu, tels que facturés le 29 et le 30 octobre 2026. Nous n’avons pas converti en euros, car le prix du crédit dépend de l’abonnement. Les quatre modèles du test 4 sont facturés en dollars par la plateforme tierce ; ils figurent dans le tableau, pas dans le graphique.
| Sortie | Modèle | Crédits | Retenu ? |
|---|---|---|---|
| 2 vues extérieures | Nano Banana 2.1 | 16 | Oui |
| 6 vues intérieures | Nano Banana 2.1 | 48 | Oui, 6 sur 6 |
| 2 vues, 4 modèles sur FLORA | GPT Image 2.5, FLUX 3, Seedream 5 Pro, Nano Banana 2.1 | 0,51 $ au total | Oui, 8 sur 8, usages différents |
| 5 plans de caméra « fidèles » | H3 Max | 252 | Oui, comme présentation de la maquette |
| Vidéo 8 s, images clés séparées | H3 Max | 48 | Non, fondu |
| Vidéo 8 s, images clés séparées | Seedance 2.5 | 288 | Non, fondu |
| Vidéo 8 s, image de fin corrigée | Seedance 2.5 | 288 | Oui |
Ce qu’on en retient
1. La référence de structure fait le travail. Avec une capture de la maquette en structure, le modèle d’image n’a jamais déplacé une fenêtre ni changé une pente de toit. Sans elle, nous l’avons vu sur d’autres essais, il redessine la maison. C’est le réglage qui compte, avant le prompt.
2. L’IA complète, et ne dit pas quoi. Chemin, plantes, usure, vue, personnes, objets : tout ce que la maquette ne contient pas est inventé, de façon plausible. Une image générée doit être publiée avec une légende qui le dit, et jamais comme un relevé.
3. Le modèle d’image choisit entre fidélité et réalisme, pas entre bon et mauvais. Sur les mêmes captures, FLUX 3 et Seedream 5 Pro habillent la maquette, GPT Image 2.5 et Nano Banana 2.1 la réinterprètent. Choisir le modèle d’après l’usage de l’image : contrôle d’un aménagement, ou ambiance pour un client.
4. En vidéo, le problème est entre les images clés, pas dans le modèle vidéo. Deux modèles aux prix très différents ont raté de la même façon sur les mêmes images, et réussi dès que les images étaient cohérentes. Avant de payer la vidéo, vérifier que les deux images clés décrivent le même décor.
5. « Fidèle » n’est pas « réaliste ». Le rendu qui garde le style de la 3D est propre et bon marché, mais il montre une maquette. Choisir avant de lancer : montrer le modèle, ou montrer une ambiance.
6. Le coût est dans les essais ratés. Les images réussies ont coûté 64 crédits. Les vidéos ratées en ont coûté 336. La méthode qui marche est connue maintenant, elle est dans cet article, et elle ne coûte plus que le prix d’une seule vidéo.
Limites
- Un seul bâtiment, une seule vue par chemin, un seul essai par cellule. Le test 4 n’a pas été fait dans ChatGPT lui-même mais avec son modèle d’images appelé via FLORA ; les réglages par défaut de la plateforme (qualité « high » pour GPT Image, 1K pour tous) ont été gardés. H3 Max n’a pas été relancé après la correction de l’image de fin : nous ne savons pas s’il aurait réussi aussi, pour six fois moins cher.
- Les crédits sont ceux d’un studio de rendu intégré au modeleur. Les mêmes modèles accessibles ailleurs ont d’autres tarifs.
- La maquette est reconstituée sans visite, depuis une photo et des données publiques ; ses propres erreurs sont décrites sur la page méthode. Les images d’ambiance en héritent.
- Aucun de ces rendus ne vaut candidature ni document de la Ville de Liège.
Protocole
- Maquette : existant reconstitué (version 5 du 28 octobre 2026) et aménagement « maison du parc » dans une copie, modeleur 3D avec studio de rendu intégré.
- Images : Nano Banana 2.1, capture de la maquette en référence « structure », un rendu existant en référence « style » pour les intérieurs, prompt de photographie d’architecture, une génération par vue, 8 crédits par image. Extérieurs le 29 octobre, intérieurs le 30 octobre 2026.
- Vidéos : 8 secondes, image de début et image de fin. Chemin A : parcours de caméra dans le modeleur, H3 Max, rendu « fidèle », 48 crédits par plan. Chemin B : H3 Max (6 crédits par seconde) et Seedance 2.5 (36 crédits par seconde) sur les deux rendus du test 1. Chemin C : image de fin rendue avec la capture de fin en structure et le rendu de début en style, consigne « reproduire exactement la même scène », puis Seedance 2.5. Le 29 octobre 2026.
- Test 4 : plateforme FLORA, image-vers-image, une capture par couple (extérieur 1920 × 1080, café 1920 × 1080), prompt identique en anglais pour les quatre modèles, format 16:9, résolution 1K, qualité « high » pour GPT Image 2.5. Le 30 octobre 2026.
- Les fichiers sources (captures, rendus en pleine résolution, vidéos d’origine) sont archivés et disponibles sur demande à bonjour@airplan.be.